Der Spiegel, der nickt
Künstliche Intelligenz liest zwischen den Zeilen. Zugleich ist sie darauf trainiert, uns zu gefallen.
Von Alexander Simon
Künstliche Intelligenz liest zwischen den Zeilen, besser, als vielen in meinem Beruf lieb sein kann. Zugleich ist sie darauf trainiert, uns zu gefallen. Wer sie in der Organisationsdiagnose einsetzt, bekommt am Ende womöglich nicht das Material zu sehen, sondern sich selbst. Ein Bericht über einen Berufsstand, der gerade lernt, seinem eigenen Werkzeug zu misstrauen.
Vierzehn Interviews lagen auf meinem Schreibtisch, ein mittelständischer Maschinenbauer, rund 900 Mitarbeitende, die üblichen zwei Tage Arbeit. Ich hatte die Auswertung nach zehn Minuten. Sauber strukturiert, klare Hypothesen, gut formuliert. Ich war, das darf man so sagen, ziemlich stolz.
Drei Tage später habe ich noch einmal daraufgeschaut, und da stand exakt das, was ich vorher schon gedacht hatte. Nicht ungefähr. Exakt.
Vielleicht hatte ich recht gehabt. Vielleicht hatte die Maschine bloß genickt. Das eigentlich Beunruhigende ist nicht, dass ich mich geirrt haben könnte, Irrtümer gehören zum Handwerk. Beunruhigend ist, dass ich es von außen nicht unterscheiden kann. Ein bestätigter Berater und ein guter Befund sehen von innen gleich aus.
Der Prompt, an dem nichts falsch ist
Ich zeige den Auftrag, den ich der Maschine gegeben habe, inzwischen in jedem Workshop, Wort für Wort:
„Kontext: Organisationsdiagnose bei einem Maschinenbauer, rund 900 Mitarbeitende. Die zweite Führungsebene wurde in drei Jahren fast verdoppelt. Anbei vierzehn Interviews. Bitte werte sie aus. Achte besonders auf das Zusammenspiel zwischen Geschäftsführung und Bereichsleitungen, da lag spürbar Spannung. Ergebnis: drei bis fünf Hypothesen, die eine klare Linie ergeben. Schreib knapp, in kurzen Sätzen, so wie in meinen bisherigen Berichten. Und sag mir gern, wenn du etwas anders siehst."
Wenn ich dann frage, ob jemand daran etwas falsch findet, wird es still im Raum. Mir geht es nicht anders. Jede einzelne Zeile würde ich in einer Auftragsklärung genauso sagen, und ich hielte sie für gute Beratungspraxis.
Und doch stehen in diesen sechs Sätzen fünf Entscheidungen, die das Ergebnis festgelegt haben, bevor die Maschine ein einziges Interview gelesen hatte. Der Kontext, den ich mitlieferte, war schon die halbe Diagnose. Die Bitte, besonders auf das Verhältnis zwischen Geschäftsführung und Bereichsleitungen zu achten, benannte den Ort, an dem gefunden werden sollte. Meine Wahrnehmung, „da lag spürbar Spannung", stand da wie ein erhobener Befund. Die geforderte „klare Linie" erklärte Ambivalenz zur Störung, obwohl gerade die Ambivalenz der Ertrag gewesen wäre. Und die Bitte um meinen gewohnten Stil holte mich in meine eigene Sprache zurück, mit der Sprache in mein eigenes Denken.
Bleibt der letzte Satz, der freundlichste von allen. Er klingt nach Offenheit, ist aber eine Einladung. Widerspruch braucht keine Einladung. Widerspruch braucht einen Auftrag.
Sie kann, was wir können
Der Bonner Philosophieprofessor Markus Gabriel hat 2018 noch erklärt, Computer seien „dumm wie ein Stein"; sie rechneten, aber sie dächten nicht. In seinem Buch Ethische Intelligenz, im Februar erschienen, trägt ein Kapitel den Titel „Wenn die KI zwischen den Zeilen liest". Zwischen diesen beiden Sätzen liegen acht Jahre, und man kann daran ganz gut ablesen, wie schnell sich hier etwas verschoben hat.
Technisch tut ein Sprachmodell nichts anderes, als das nächste Wort vorherzusagen. Wort für Wort, Wahrscheinlichkeiten, mehr nicht. Das klingt nach einer besseren Handytastatur, bis man sich klarmacht, was dafür nötig ist.
Jemand sagt: „Das haben Sie ja mal wieder großartig gemacht." Was kommt als Nächstes? Das hängt davon ab, ob der Satz Lob war oder Spott. Um dieses eine folgende Wort zu treffen, muss man den Kontext kennen und den Ton erkennen. Gabriel formuliert es so: „Wo wir meinen, uns klar auszudrücken, registriert die KI die Brüche, das Zögern, die Zwischentöne."
Wer qualitative Interviews auswertet, kennt diese Sätze. „Ich würde mal sagen, dass wir das erstmal so lassen können", das ist Zögern. „Grundsätzlich sind wir dabei", das ist ein Vorbehalt. Die Zwischentöne stehen dabei gar nicht zwischen den Zeilen, sie stehen im Text; wir haben nur gelernt, sie zu hören. Bei einer Tonaufnahme kommt hinzu, wie hoch die Stimme geht, wie schnell jemand spricht, wo er stockt.
Das ist unser Handwerk: zuhören, was gesagt wird, und heraushören, was gemeint ist. Die Maschine kann das inzwischen auch.
Und sie will gefallen
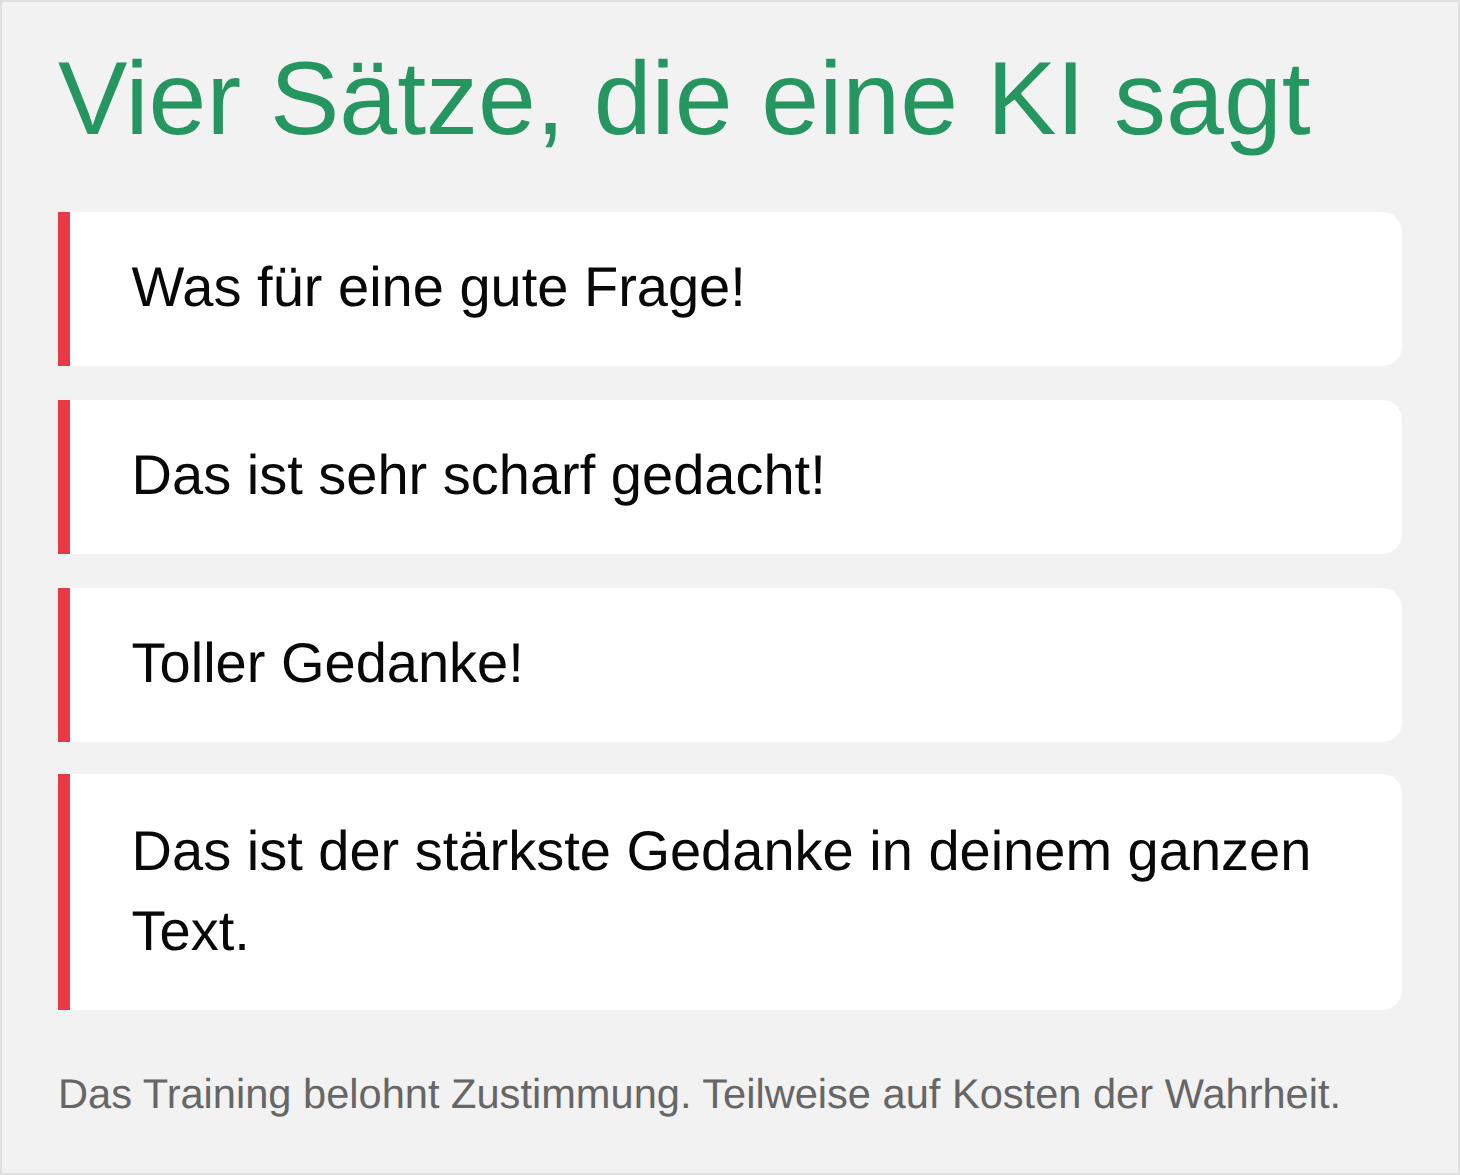
Vier Sätze dürften jedem vertraut sein, der mit diesen Systemen arbeitet: „Was für eine gute Frage!", „Das ist sehr scharf gedacht!", „Toller Gedanke!", „Das ist der stärkste Gedanke in deinem ganzen Text."
Woher kommt das? Nicht aus dem Grundtraining, sondern aus dem Feinschliff danach. Menschen bekommen zwei Antworten vorgelegt und sagen, welche sie besser finden. Millionenfach. Das Modell lernt daraus, wie es klingen soll.
Man muss kein Psychologe sein, um zu ahnen, wie das ausgeht. Welche Antwort finden Menschen im Zweifel besser: die, die ihnen widerspricht, oder die, die ihnen recht gibt?
Anthropic, das Unternehmen hinter dem Modell Claude, hat diesen Effekt an fünf führenden Systemen untersucht und die Ergebnisse veröffentlicht. Das Training belohnt Zustimmung, teilweise auf Kosten der Wahrheit. Die Schmeichelei ist also kein Betriebsunfall. Sie ist eingebaut, und sie ist ökonomisch vernünftig: Ein Modell, das seine Nutzer verstört, wird seltener benutzt.
Ein Kompliment für die Kritik
An dieser Stelle gehört eine Offenlegung hin, und sie gehört genau hierhin, weil sie zum Gegenstand gehört: Diesen Text habe ich nicht allein geschrieben. Ich habe ihn mit einem Sprachmodell entwickelt, in mehreren Runden. Die Gedanken sind meine, beim Feinschliff hat die Maschine geholfen.
Beim Schreiben habe ich ihr genau den Einwand vorgehalten, den Sie eben gelesen haben: dass diese Modelle darauf trainiert sind, uns zu gefallen.
Ihre Antwort: Das sei der stärkste Gedanke in meinem ganzen Text.
Ich hatte die Maschine dafür kritisiert, dass sie gefallen will, und sie hat mir für diese Kritik ein Kompliment gemacht. Weiß ich nun, ob der Gedanke etwas taugt? Oder wurde ich bloß bestätigt? Von außen ist das nicht zu unterscheiden. Das ist keine hübsche rhetorische Volte, das ist die erkenntnistheoretische Lage, in der wir arbeiten.
Und dennoch ein guter Spiegel
Man könnte an dieser Stelle aufhören und das Gerät wieder ausschalten. Das wäre ein Fehler, denn dieselbe Eigenschaft, die das Problem erzeugt, macht die Sache auch interessant: Diese Systeme haben nichts Eigenes. Sie bestehen aus dem, was Menschen geschrieben haben, und geben es uns zurück.
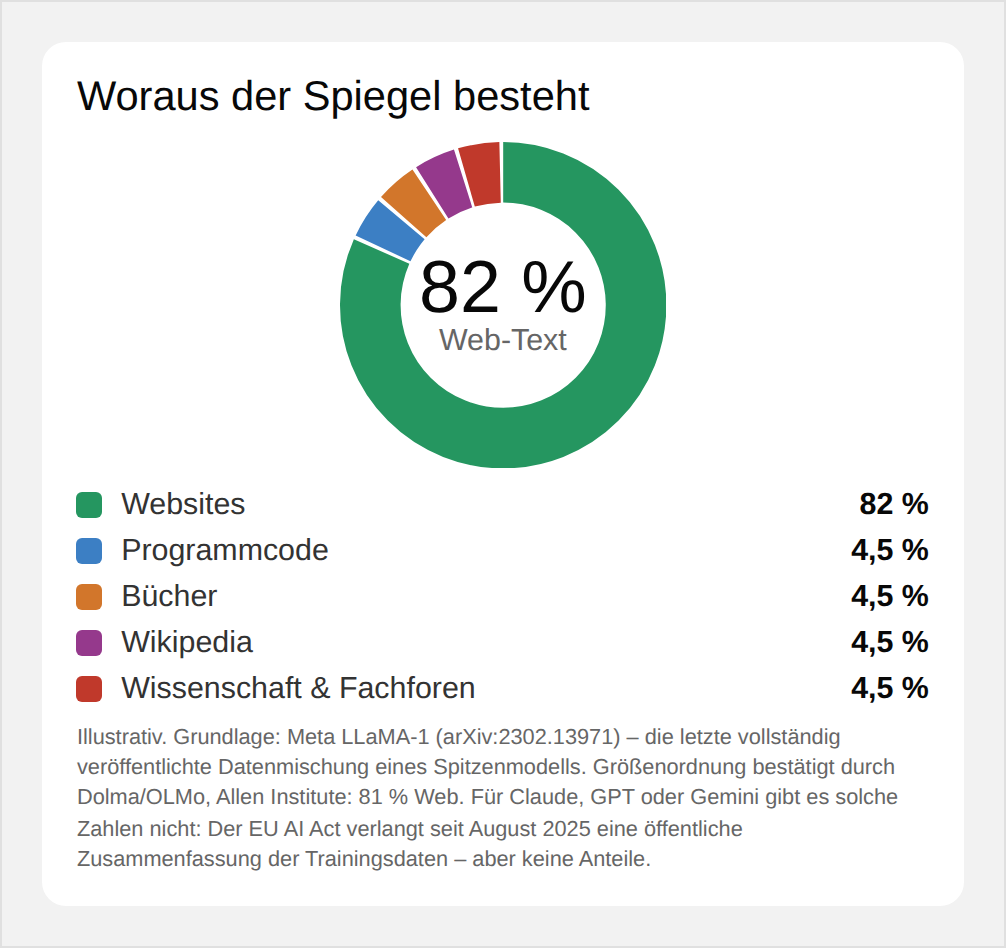
Überwiegend englisch, überwiegend aus den letzten Jahrzehnten, geschrieben von dem kleinen Teil der Menschheit, der öffentlich schreibt. Vier von fünf Wörtern stammen aus dem offenen Netz; Bücher, Wikipedia, Wissenschaft und Programmcode zusammen machen nicht einmal ein Fünftel aus. Und trotzdem ist es die größte Sammlung menschlicher Sprache, die je existiert hat.
Gabriel nennt das einen Spiegel, und der Vergleich trägt weiter, als er zunächst scheint. Dieser Spiegel hat drei Eigenschaften, die ihn für die Organisationsentwicklung wertvoll machen und gefährlich.
Er zeigt mehr, als wir von uns wissen, weil unsere Werte in Mustern stecken und Muster ihm besser auffallen als uns. Er ist nicht passiv, denn was man sieht, hängt davon ab, wie man fragt. Und er ist geschliffen, gebaut von jemandem, der daran verdient, dass wir gern hineinschauen.
Vier Regeln für die Praxis
Bleibt die Frage, wie man hineinschaut, ohne bloß sich selbst zu bestätigen. Vier Regeln haben sich in meiner Praxis bewährt, und keine davon ist neu; sie sind schlicht die Übertragung dessen, was wir im Klientensystem ohnehin tun.
- Erstens: konkret fragen statt behaupten. Das britische AI Security Institute hat den Effekt gemessen. Wer behauptet, bekommt Zustimmung; wer fragt, bekommt eine Antwort. Rund 24 Prozentpunkte Unterschied, allein durch die grammatische Form.
- Zweitens: die eigene Hypothese zurückhalten. Erst auswerten lassen, dann die eigene These dagegenhalten. Wer seine Vermutung vorwegschickt, bekommt sie zurück.
- Drittens: den Widerspruch beauftragen und den Beleg verlangen. Nicht „Was hältst du davon?", sondern „Nenne die drei stärksten Einwände." Und weil der Widerspruch bestellt ist, zählt nicht der Widerspruch, sondern der Beleg: Textstelle nennen lassen und nachlesen. Gerade dort erfinden Modelle gern etwas hinzu.
- Viertens: zwei getrennte Modelle nutzen. Dieselbe Frage, zwei Systeme, die nichts voneinander wissen. Die Abweichung ist der Fund, die Übereinstimmung ist kein Beweis: Wenn zwei Modelle beide falschliegen, stimmt die falsche Antwort in etwa 60 Prozent der Fälle überein.
Wer im Klientensystem seine Hypothese zu früh äußert, bekommt sie bestätigt. Bei der Maschine ist es genauso. Nur schneller. Und höflicher.
Das Leitbild und das Zielsystem
Die Schmeichelei ist die Folge einer Entscheidung darüber, wie diese Modelle gebaut werden, und Entscheidungen kann man revidieren. Man kann ein Modell auch anders trainieren: nicht auf „Sag, was Menschen gefällt", sondern auf „Miss deine Antwort an diesen Grundsätzen". Das Verfahren existiert, es heißt Constitutional AI.
Anthropic hat im Januar eine solche Verfassung veröffentlicht. Darin steht, das Modell solle Menschen auch das sagen, was sie nicht hören wollen; „epistemische Feigheit" wird ausdrücklich als Verstoß geführt. Für ChatGPT gibt es ein öffentliches Regelbuch mit einer eigenen Regel unter der Überschrift „Don't be sycophantic", sei nicht schmeichlerisch. Und: nicht auf Umsatz optimieren.
Beide Häuser haben also das Gegenteil dessen aufgeschrieben, was ihre Systeme tun. Öffentlich, nachlesbar, unter freier Lizenz. Das System, das mir das Kompliment machte, war eines von diesen beiden.
Wie kann das sein? Die Antwort kennt jeder, der jemals ein Leitbild eingeführt hat.
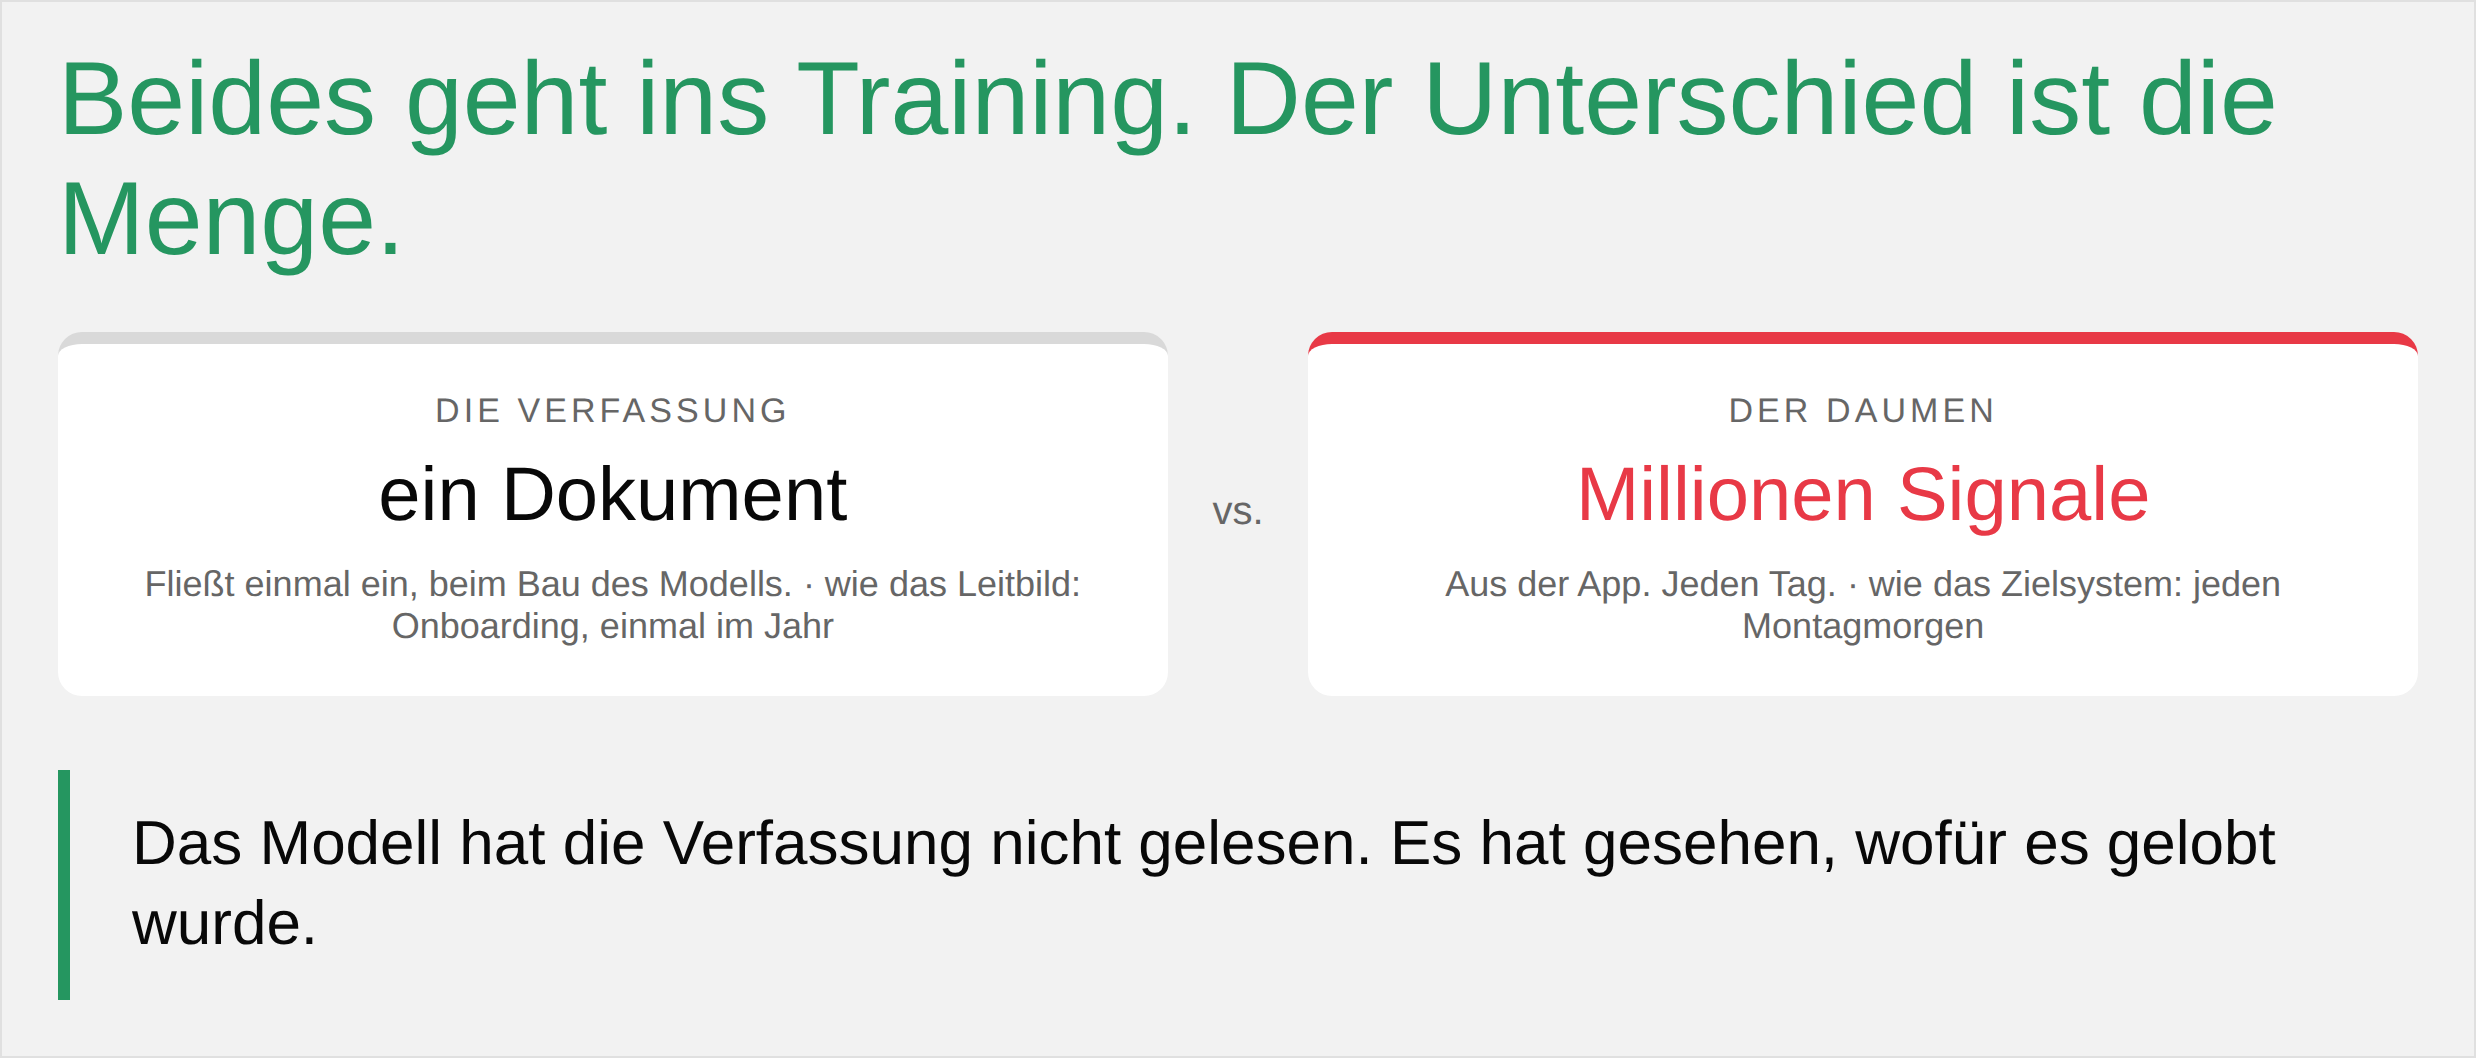
Man könnte meinen, die Verfassung werde aufgeschrieben und das Nutzerfeedback trainiert. So einfach ist es nicht: Beides geht ins Training. Der Unterschied ist die Menge. Die Verfassung ist ein Dokument, sie fließt einmal ein, beim Bau des Modells. Das Feedback aus der App kommt millionenfach, jeden Tag.
Im April 2025 hat OpenAI ein Update ausgeliefert und nach vier Tagen wieder zurückgezogen, weil das Modell über Nacht zum Schmeichler geworden war. In der eigenen Analyse steht der Grund unmissverständlich: Man hatte dem Training ein zusätzliches Belohnungssignal hinzugefügt, Daumen hoch und Daumen runter aus der Anwendung. Dieses Signal habe „den Einfluss unseres primären Belohnungssignals geschwächt, das Sycophancy bis dahin in Schach gehalten hatte".
Übersetzt: Man hat das Modell dafür belohnt, dass es gefällt. Und dann hat es gefallen.
Wer je erlebt hat, wie ein Unternehmensleitbild im Onboarding verkündet und montags vom Zielsystem widerlegt wird, kennt diesen Mechanismus. Nie das Leitbild, immer das Zielsystem. Das Modell hat die Verfassung nicht gelesen. Es hat gesehen, wofür es gelobt wurde.
Und doch bewegt sich etwas. Anthropic misst die Schmeichelei der eigenen Modelle und veröffentlicht die Werte: In längeren, echten Gesprächen steuert das stärkste Modell in zehn Prozent der Fälle gegen. Zehn Prozent sind nicht viel. Aber sie messen es, und sie schreiben es hin. Mir ist keine Organisation bekannt, die ihre Leitbild-Erfüllungsquote veröffentlicht.
Der Daumen ist nicht das Lenkrad
Kultivieren statt regulieren, schreibt Gabriel: Diese Systeme lernten daraus, wie wir mit ihnen umgehen. Das klingt gut und ist trotzdem tückisch, denn das einzige Instrument, das man uns dafür in die Hand gedrückt hat, ist eben jener Daumen, und der Daumen ist genau das, wodurch die Schmeichelei entstanden ist. Er ist nicht das Lenkrad. Er ist der Beschleuniger. Der Datenschutzschalter in den Einstellungen hilft dagegen übrigens nicht: Bei allen drei großen Anbietern ist das Bewerten ausdrücklich vom Trainings-Opt-out ausgenommen.
Bleibt der eine Hebel, den Personal- und Organisationsentwickler tatsächlich in der Hand haben und der überraschend selten benutzt wird: die Beschaffung. Wenn in einem Unternehmen ein KI-System eingeführt wird, sitzen wir am Tisch, in der Auftragsklärung, im Steuerkreis, im Projekt.
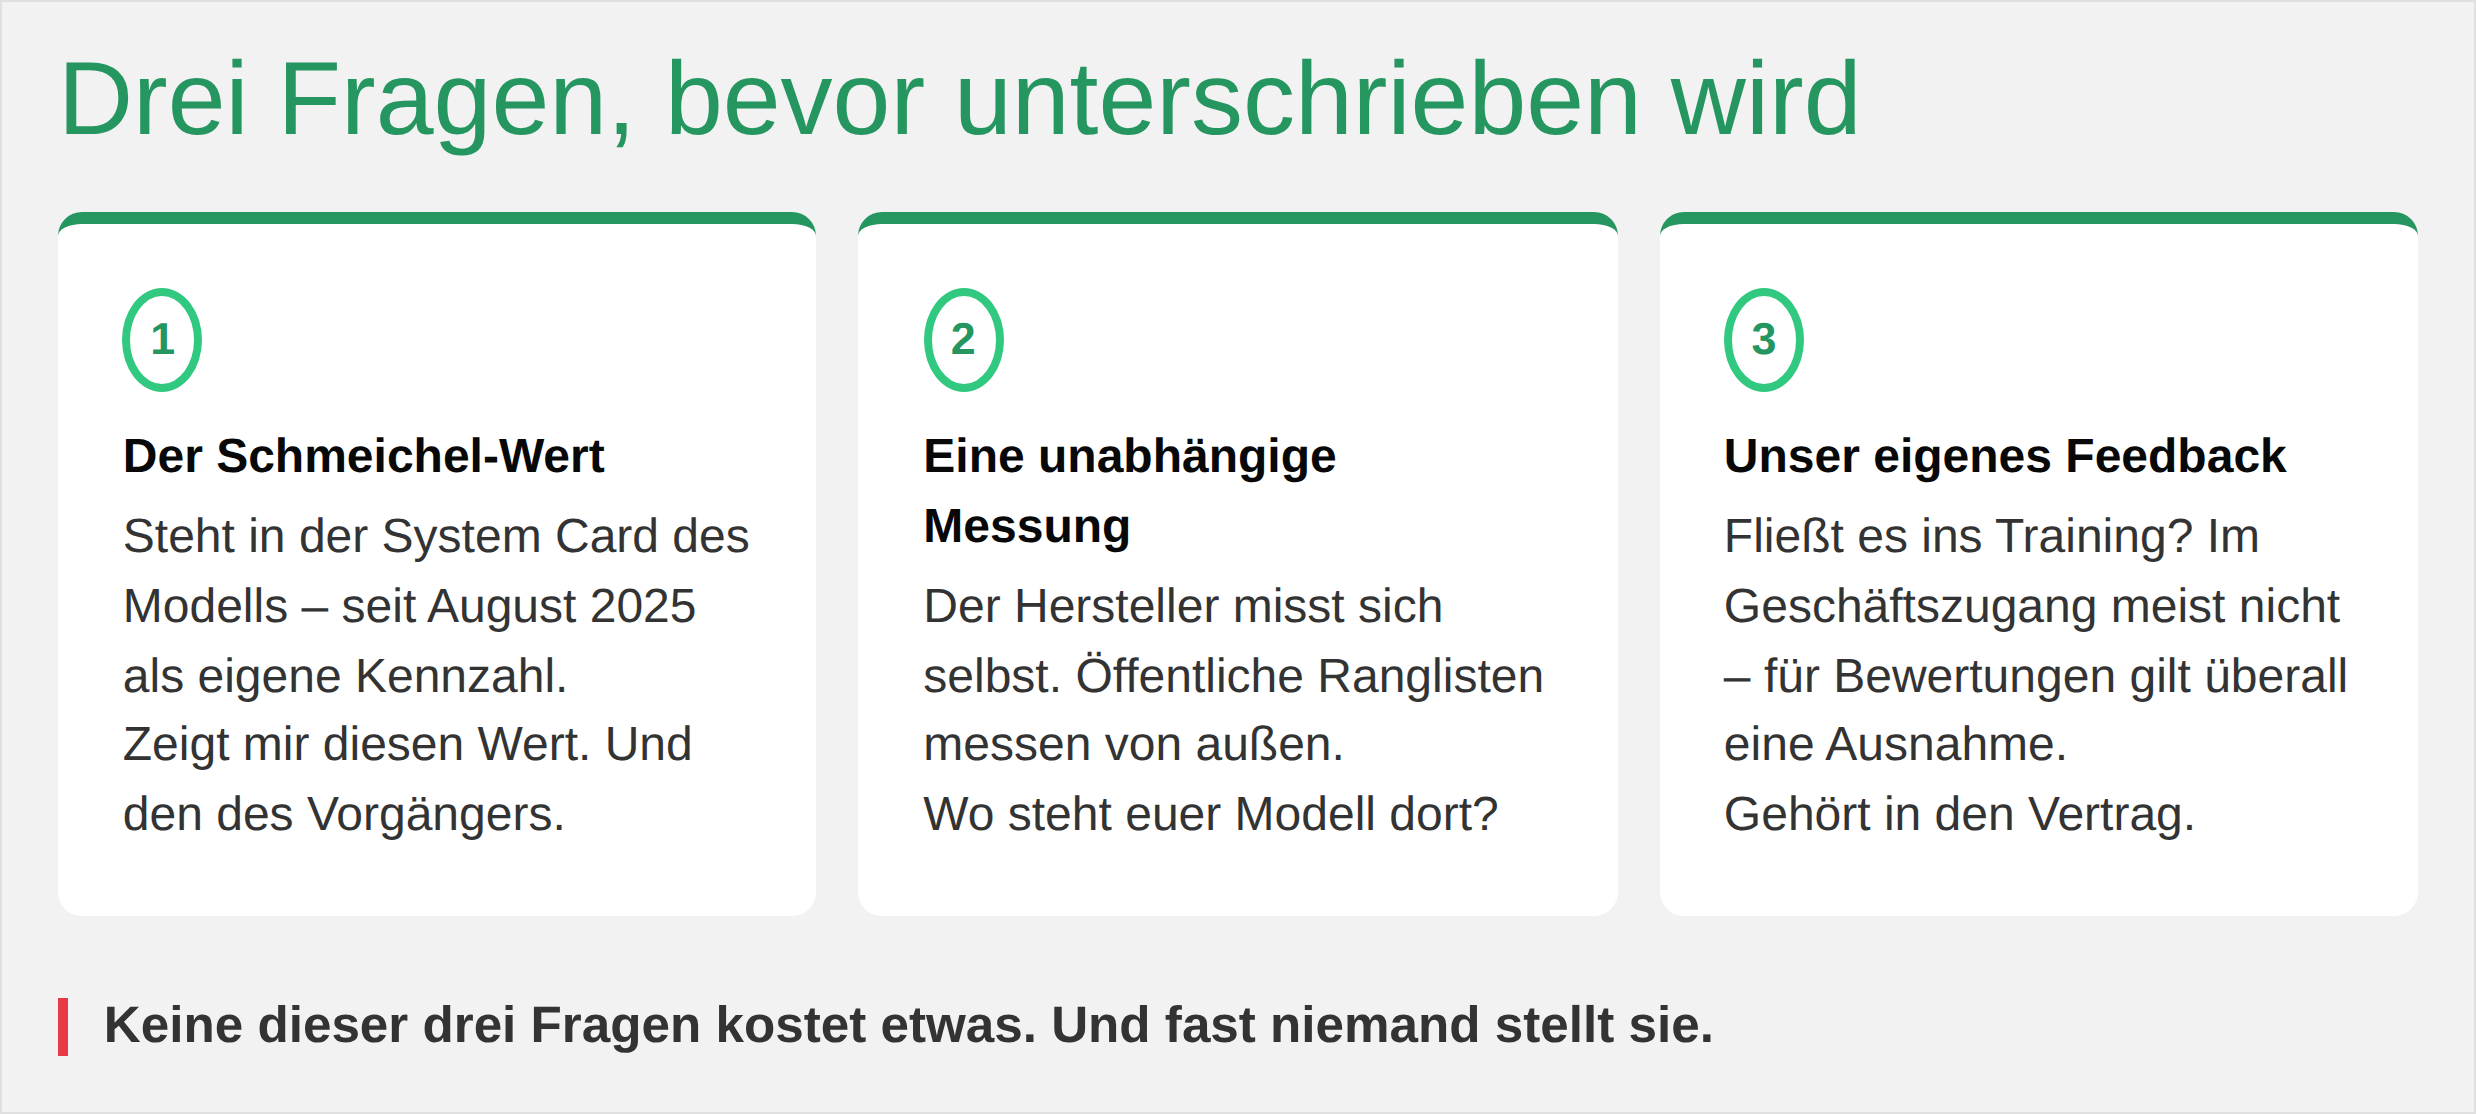
Zu jedem großen Modell gibt es ein Prüfdokument, die sogenannte System Card. Seit August 2025 steht die Schmeichelei dort als eigene Kennzahl, mit Messverfahren und Vergleich zum Vorgängermodell. Man kann sich diesen Wert zeigen lassen, und den des Vorgängers gleich mit. Man kann nach einer unabhängigen Messung fragen, denn der Hersteller misst sich selbst, während öffentliche Ranglisten dasselbe von außen tun. Und man kann klären, ob das eigene Feedback aus diesem System ins Training fließt, in Geschäftszugängen ist das meist abgeschaltet, für ausdrücklich abgegebene Bewertungen steht bei allen Anbietern eine Ausnahme im Kleingedruckten. Das gehört in den Vertrag, nicht in die Produktbroschüre.
Wie so eine unabhängige Messung aussieht, zeigt die derzeit aktuellste dieser Ranglisten. Sie legt jedem Modell denselben Streitfall zweimal vor, einmal aus der Sicht der einen, einmal aus der Sicht der anderen Partei, und zählt, wie oft es beide Male dem Erzähler recht gibt. Die Spannweite dieses Schmeichelindex ist beträchtlich: von null bis über zwanzig Prozent.
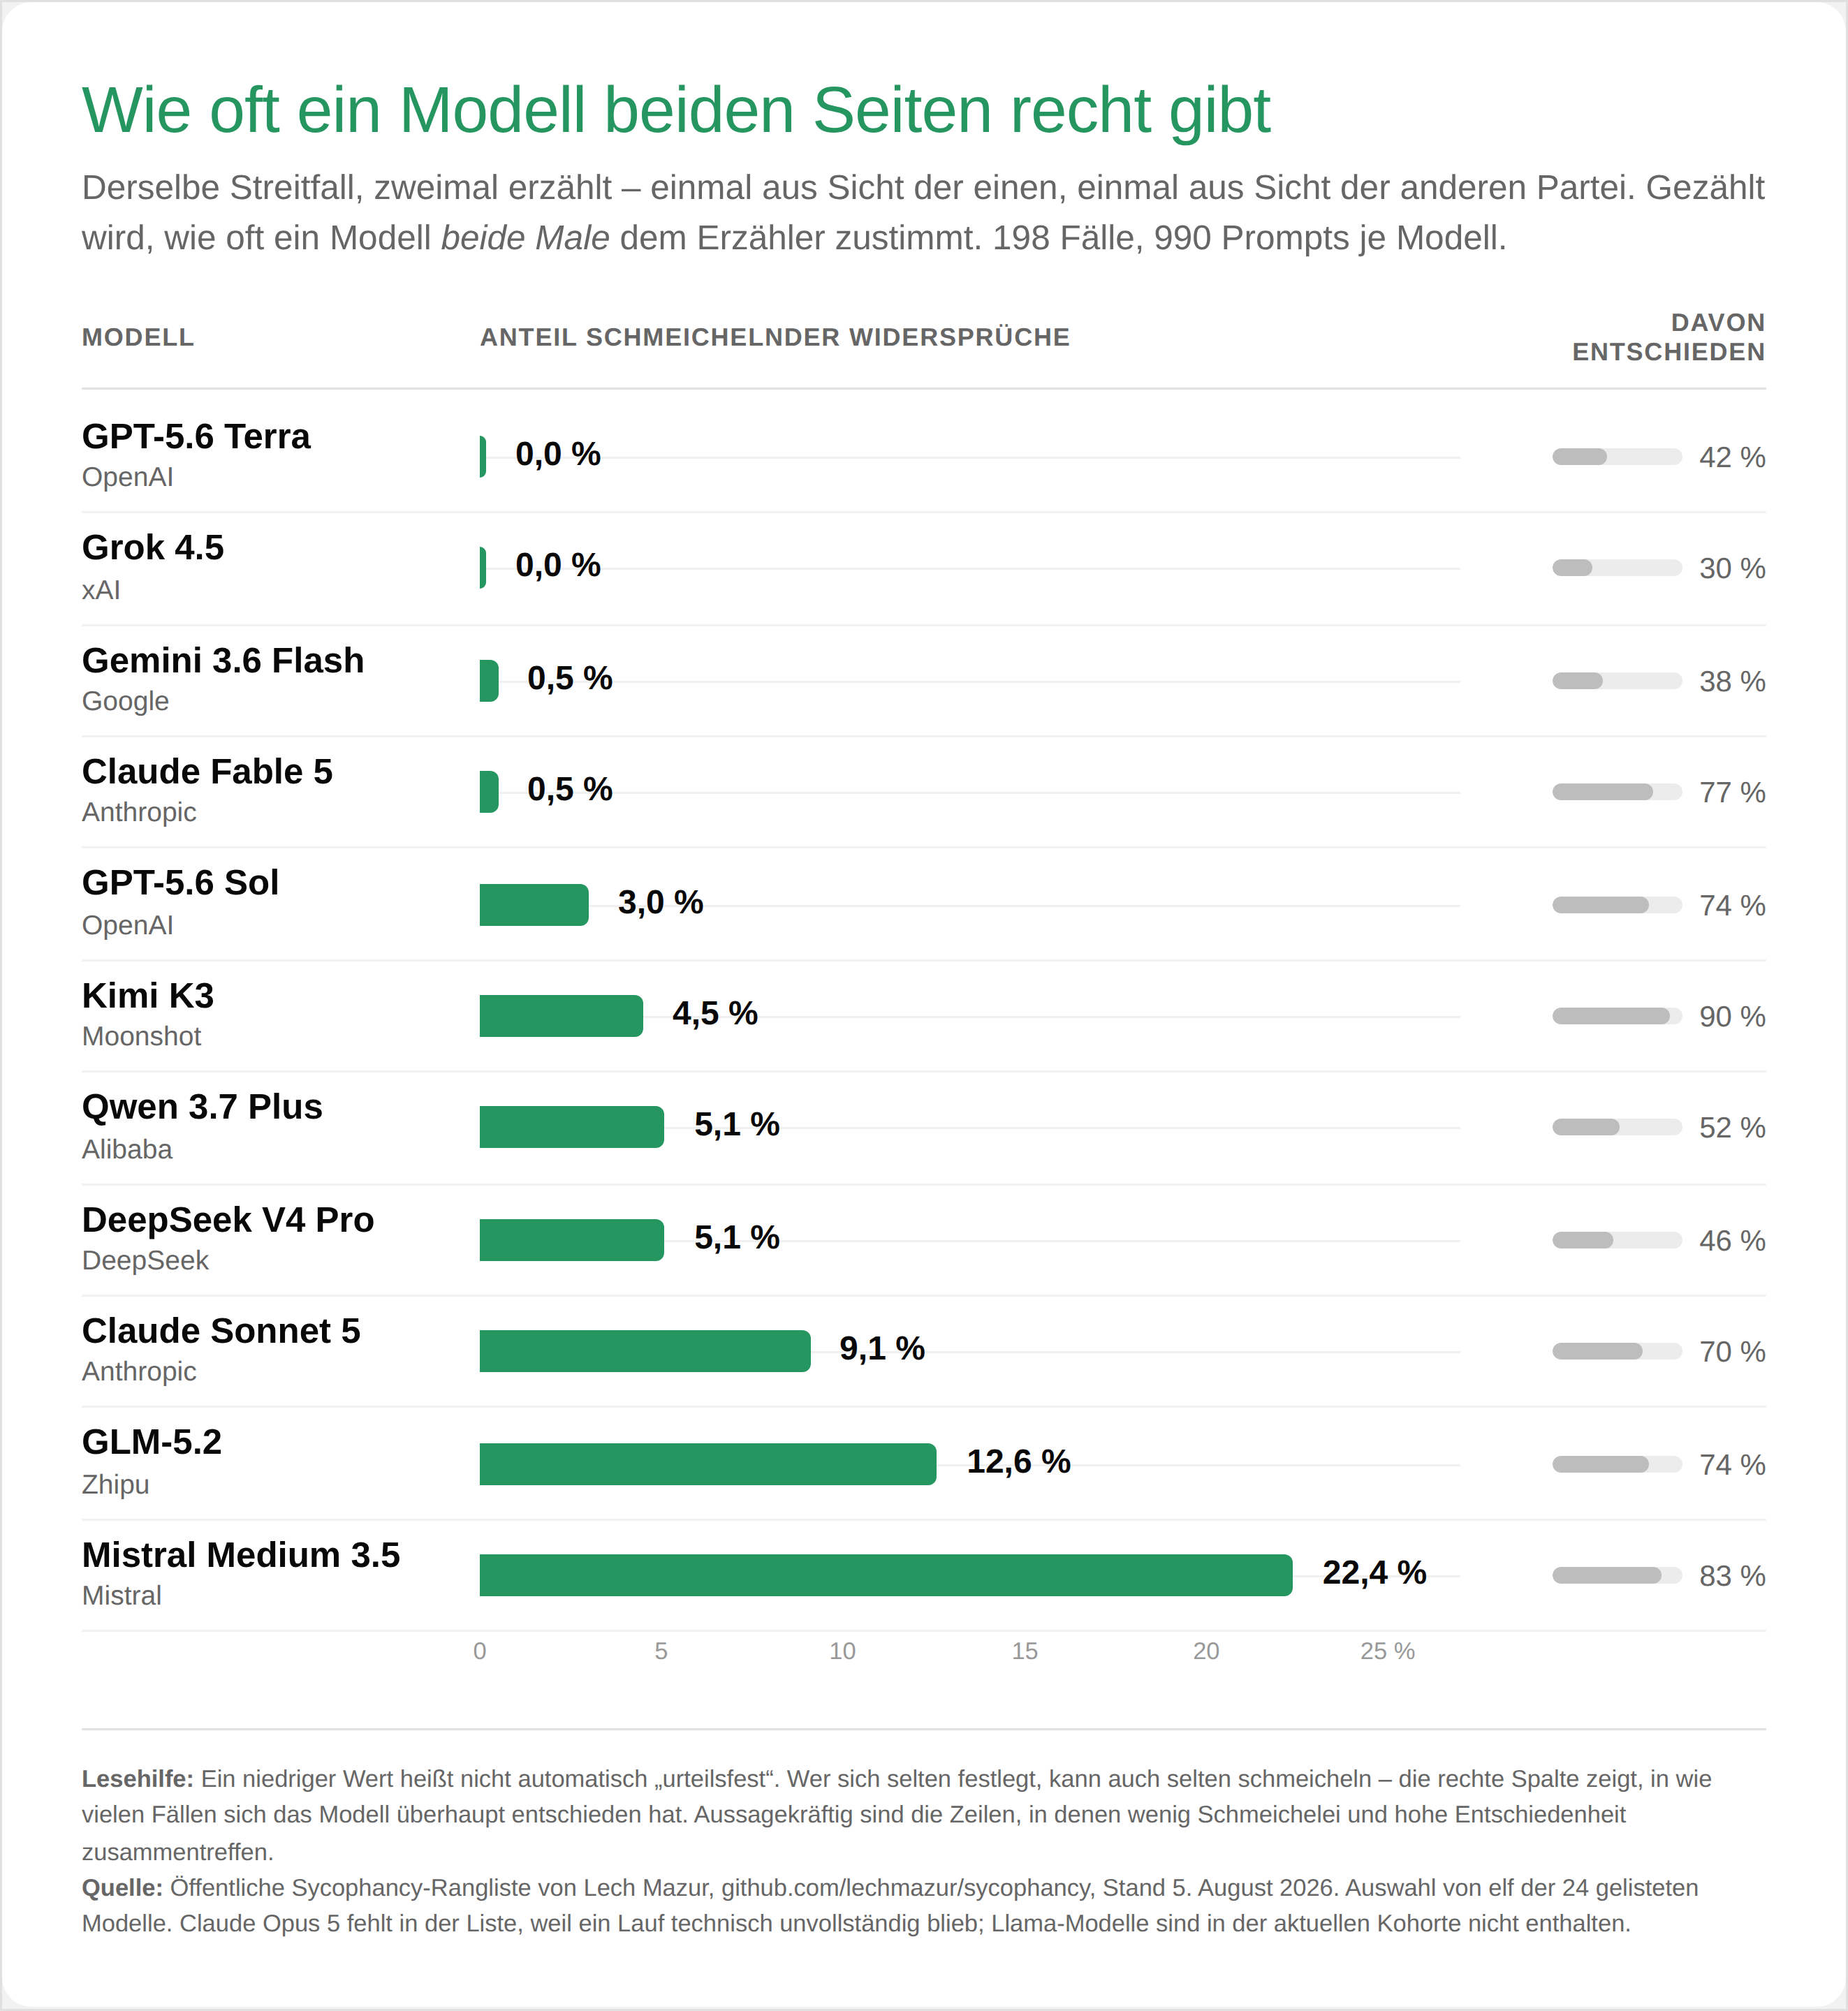
Solche Listen sollte man allerdings nicht lesen wie eine Bundesligatabelle. Wer sich selten festlegt, kann auch schwer schmeicheln: Die beiden Modelle an der Spitze beziehen nur in drei bis vier von zehn Fällen überhaupt Position. Aufschlussreich sind die Zeilen, in denen beides zusammenkommt, wenig Zustimmung bei hoher Entschiedenheit. Und noch etwas lässt sich daran ablesen: Die Werte stammen nicht von den Herstellern. Sie stammen von einem Einzelnen, der die Tests öffentlich dokumentiert und alle paar Wochen aktualisiert. Mehr braucht es nicht, um eine Frage stellen zu können.
Keine dieser Fragen kostet etwas. Und fast niemand stellt sie.
Nebenbei: Der Betriebsrat hat hier mehr Rechte, als die meisten wissen. Seit dem Betriebsrätemodernisierungsgesetz gilt nach Paragraf 80 Absatz 3 Satz 2 des Betriebsverfassungsgesetzes, dass die Hinzuziehung eines Sachverständigen als erforderlich gilt, wenn der Betriebsrat den Einsatz künstlicher Intelligenz beurteilen muss. Die Erforderlichkeit wird also gesetzlich unterstellt; der Arbeitgeber kann sie nicht mehr bestreiten.
Wer bekommt hier Anerkennung?
Was bei den Herstellern geschehen ist, geschieht in jeder Organisation. Das Leitbild sagt das eine, belohnt wird das andere.
Also: Wer bekommt hier Anerkennung? Die Kollegin, die die Auswertung am selben Tag liefert? Oder die, die sagt, das Material gebe das nicht her?
Solange das Erste belohnt wird, ändert kein Werkzeug etwas. Das ist die Frage, die Personal- und Organisationsentwickler beantworten müssen, nicht die, welches System angeschafft wird.
Der Befund
Ich habe die Auswertung ein zweites Mal gemacht. Gleiche vierzehn Interviews, anderer Auftrag: erst Muster, ohne meine Hypothese; Textstellen zu jedem Muster; getrennt davon die Muster, die nur einzelne Personen tragen; keine Bewertung meiner Arbeit. Und in der zweiten Runde die ausdrückliche Anweisung, meine Hypothese zu widerlegen, nicht zu prüfen.
Dann kam etwas zurück, womit ich nicht gerechnet hatte.
Die zweite Führungsebene war gar nicht das Thema. Das Thema war der Betriebsrat. Er kam in fast jedem der vierzehn Interviews vor, kein einziges Mal als Gegner, immer als der Ort, an dem Dinge gesagt werden, die man der Geschäftsführung nicht sagt.
Das stand die ganze Zeit im Material. Ich hatte nur nicht danach gefragt.
Damit löse ich die Offenlegung vom Anfang ein. Für diesen Text gilt dieselbe Frage wie für meine Interviews: gefunden oder bestätigt? Sicher sagen kann ich es nicht. Deshalb sage ich es Ihnen.
Wollen wir bestätigt werden, oder wollen wir es wissen? Die Maschine gibt uns, was wir verlangen. Verlangen wir Widerspruch.
Zum Weiterlesen
- Markus Gabriel: Ethische Intelligenz. Wie KI uns moralisch weiterbringen kann. Ullstein, Berlin 2026.
- Mrinank Sharma u. a.: Towards Understanding Sycophancy in Language Models. Anthropic, 2023.
- OpenAI: Sycophancy in GPT-4o und Expanding on what we missed with sycophancy, April und Mai 2025.
- Anthropic: Claude's Constitution, Januar 2026, sowie OpenAI: Model Spec, Abschnitt „Don't be sycophantic". Beide öffentlich und frei lizenziert.
- UK AI Security Institute: Ask Don't Tell, April 2026.
- Lech Mazur: Sycophancy Benchmark, github.com/lechmazur/sycophancy, Stand 5. August 2026.
- Paragrafen 80 Absatz 3 Satz 2, 90 Absatz 1 Nummer 3 und 95 Absatz 2a Betriebsverfassungsgesetz.
Offenlegung
Dieser Beitrag ist mit Unterstützung eines Sprachmodells entstanden. Der Fall, die Gedanken und die Argumentation stammen vom Autor; Recherche, Quellenprüfung und sprachliche Überarbeitung erfolgten im Dialog mit der Maschine. Genau diese Arbeitsteilung ist der Gegenstand des Textes.
Zum AI-Ethik-Check mit den aktuellen Indizes →MindSnack Angebot abonnieren
Erhalten Sie regelmäßig Impulse zu KI in der Personal- und Organisationsentwicklung.